Autor: martin

  • Cynefin: Das müssen wir in der Schule lehren!

    Das falsche Werkzeug einsetzen

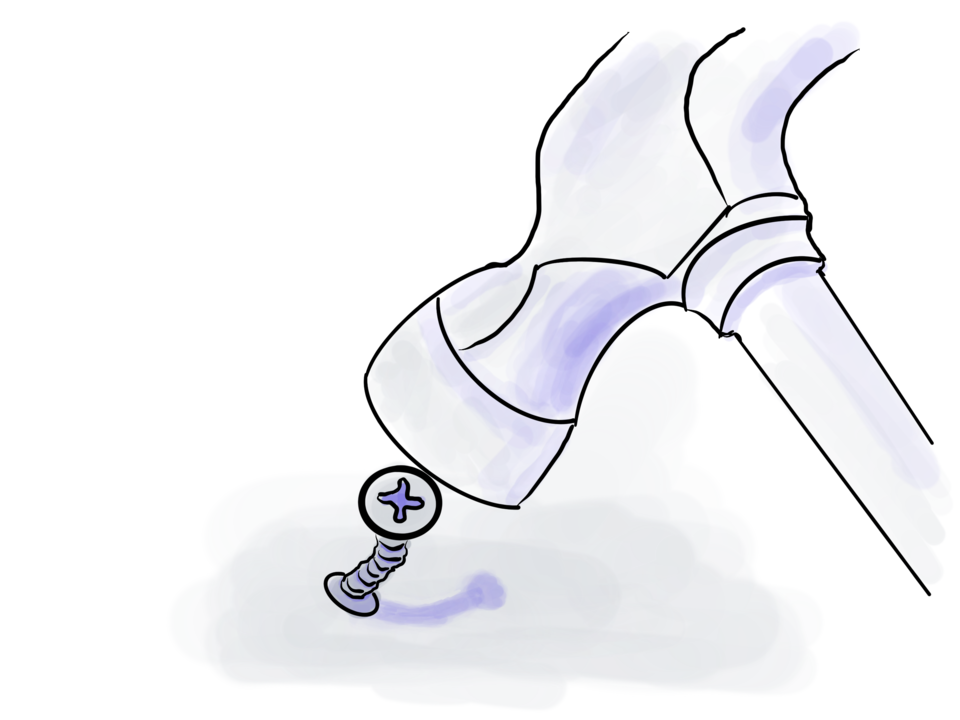
    Du kennst die Metapher sicher: der Hammer, mit dem man eine Schraube einschlägt. Die Idee, das falsche Werkzeug für ein Problem einzusetzen, kannte ich seit Jahren — das Cynefin-Framework aber hatte ich erst kürzlich kennengelernt. Es beschreibt diese Situation viel präziser, und es hat mir die Augen geöffnet. Als jemand, der selbst Opfer und Täter dieses „falschen Werkzeugs“ war, brenne ich darauf, diesen Beitrag zu schreiben. Denn so viel Schmerz ist dadurch entstanden. So viel Aufwand, Geld und Motivation wurde verschwendet. Und das Schlimmste: Es passiert jeden Tag weiter. Das muss sich ändern. Du solltest das Cynefin-Framework kennen — und das Wort weitergeben.

    Ich werde nur an der Oberfläche des Frameworks kratzen — aber das könnte schon genug sein, um deine Sicht auf die Welt zu verändern. Bei mir war es jedenfalls so, als ich das erste Mal damit in Berührung kam. Bevor ich auf das Framework eingehe, möchte ich ein paar ganz eigene Beispiele nennen, die erklären, warum wir es kennen sollten:

    • Mehrere Jahre Arbeit und viel Geld verschwendet beim Versuch, ein revolutionäres Produkt für ein großes deutsches Unternehmen zu entwickeln — behandelt wie ein Projekt mit festem Scope, ohne regelmäßiges Feedback und schnelle Kurskorrekturen.
    • Ein großes, unternehmensweites Transformationsprojekt, das mit einem Projektplan aus mehreren tausend Aufgaben gesteuert wurde.
    • Unzählige gut durchdachte Strategien und große Reorganisationen, die scheiterten oder ihre geplanten Ziele nie vollständig erreichten.
    • Bewährte Projektmanagement-Praktiken beim Bau eines Büros schlicht ignoriert.
    • Stunden und Stunden hitziger Diskussionen darüber, welche Arbeitsweise die beste ist.

    Und das sind nur meine ganz persönlichen Erfahrungen … Also, ohne weitere Umschweife: Lass mich das Cynefin-Framework kurz vorstellen. Auf diese Beispiele und einige Gedanken zur digitalen Transformation komme ich später zurück.
    Das Cynefin-Framework

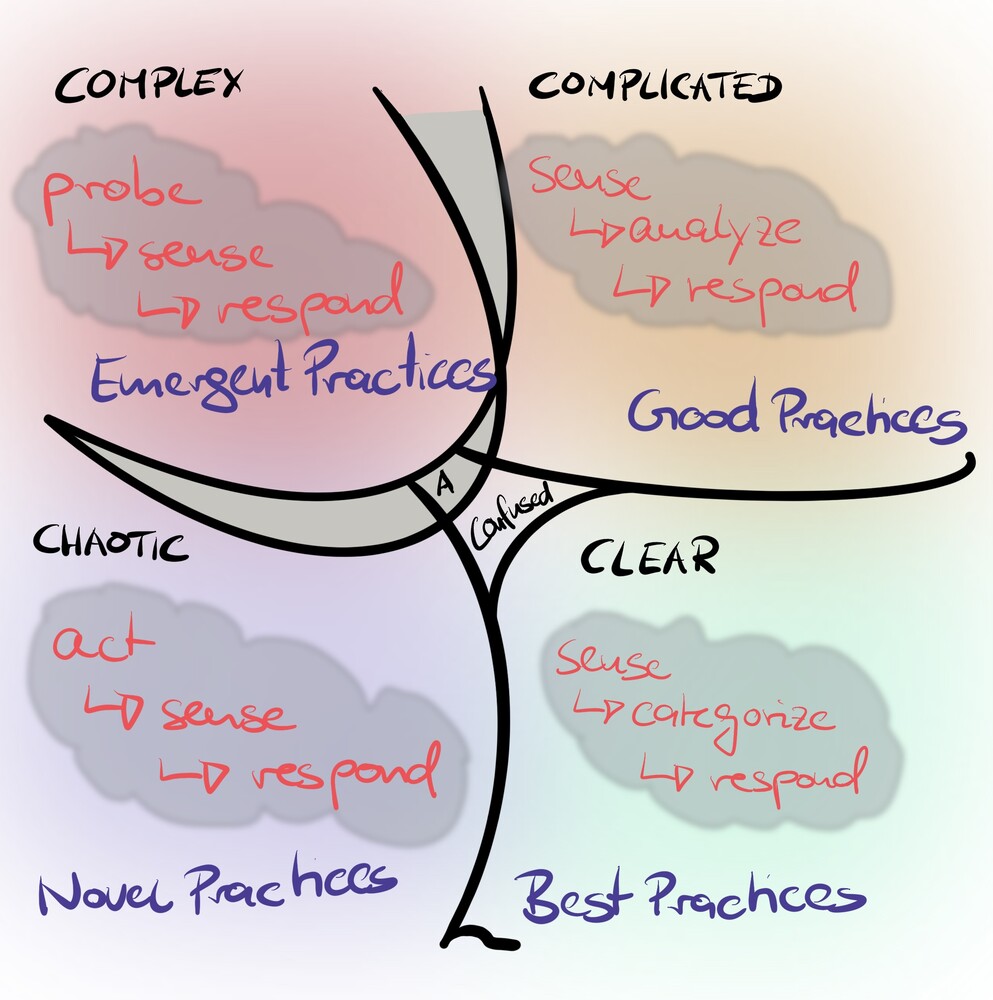
    So sieht das Cynefin-Framework aus. Du siehst vier Quadranten. Anders als viele andere Modelle hat es keine Dimensionen — also keine x- oder y-Achse. Im Wesentlichen gibt es diese vier Quadranten und einen Bereich dazwischen, der sie voneinander trennt. Auf die Grenzen und ihre unterschiedliche Dicke gehe ich hier nicht ein. Bleiben wir einfach bei: vier Quadranten. Ihre Bezeichnungen beginnen alle mit dem Buchstaben „C“: CLEAR, COMPLICATED, COMPLEX und CHAOTIC.

    Was findet sich in diesen Quadranten?

    Ich zitiere Sonja Blignaut aus dem Buch „Cynefin. Weaving Sense-Making into the Fabric of our world“. Sie schreibt: „At its most basic, Cynefin allow us to distinguish between three different kinds of systems:

    1. Ordered systems that are governed and constrained in such a way that cause and effect relationships are either clear or discoverable through analysis;
    2. Complex systems where causal relationships are entangled and dynamic and the only way to understand the system is to interact; and
    3. Chaotic systems where there are no effective constraints, turbulence prevails and immediate stabilizing action is required“.

    Beginnen wir mit Clear: Clear ist die Domäne der Best Practices. Die Lösung eines Problems ist für jeden sichtbar. Der Zusammenhang zwischen Ursache und Wirkung liegt auf der Hand — oder ist inzwischen offensichtlich. Ein paar Beispiele helfen: die Arbeit in einem Call Center — ein Kunde ruft an, der Agent hört zu und wählt dann schnell das passende Script, um dem Kunden zu helfen.

    Ein weiteres Beispiel wäre der Bau eines Einfamilienhauses. Keine einfache Aufgabe. Aber sie wurde schon milliardenfach ausgeführt. Wir haben Best Practices. Die Domäne ist vollständig verstanden. Es gibt sogar Kataloge, aus denen man sein Traumhaus auswählen kann. Übrigens: Clear, Obvious oder Simple bedeutet nicht leicht. Es kann trotzdem anspruchsvoll und harte Arbeit sein. Der Bau eines besonderen Opernhauses — etwa der Elbphilharmonie in Hamburg — fällt hingegen nicht in diese Domäne.

    Nun zur Complicated-Domäne. Hier ist die Lösung für niemanden auf Anhieb sichtbar. Man braucht Expertenwissen. Das ist die Experten-Domäne. Ein extremes Beispiel wäre der Flug zum Mond. Er erforderte ein enormes Maß an Expertenwissen und Analyse. Und doch war die Beziehung zwischen Ursache und Wirkung — wenn auch kompliziert — letztendlich versteh- und beherrschbar. Oder nehmen wir den Automobilbau. Ingenieursarbeit. Ein weiteres Beispiel aus der IT wäre der globale Rollout eines ERP-Systems. Keine leichte Aufgabe — aber wir haben Good Practices dafür. Wir können Methodologien entwickeln, Prozessdiagramme erstellen, Vorlagen und Rollenbeschreibungen definieren. Wir können physische oder kommerzielle Modelle bauen. Wir können die Arbeit schätzen und zu einem Festpreis anbieten, weil wir wissen, wie wir sie steuern. Probleme in der Complicated-Domäne zu lösen ist nicht einfach. Aber wenn man genug Köpfe — die besten Engineers und Experten — auf das Projekt ansetzt, kommt man zu einer guten Lösung. Vielleicht nicht zur besten. Aber zu einer guten. Denn die Beziehung zwischen Ursache und Wirkung lässt sich analysieren und verstehen.

    In der Complex-Domäne sieht das alles anders aus. Hier lässt sich die Beziehung zwischen Ursache und Wirkung erst im Nachhinein erkennen. Was bedeutet das? Nun — die Konsequenzen sind enorm. Egal wie viele Experten man auf ein Problem ansetzt, egal wie klug sie sind, egal wie hart man arbeitet: Man kann keine Lösung ableiten. Genauer gesagt — man kann eine Lösung entwickeln und sich selbst und andere davon überzeugen, dass sie die richtige ist. Aber da der Zusammenhang zwischen Ursache und Wirkung in der Complex-Domäne erst rückblickend sichtbar wird, täuscht man sich und andere schlicht. Und genau das passiert täglich. Ich gebe es offen zu: Ich war selbst oft ein hervorragender Täuscher.

    Um diesen Beitrag kompakt zu halten, übergehe ich die Chaotic-Domäne. Wer mehr über Cynefin erfahren möchte, findet leicht weiterführende Quellen.

    Konzentrieren wir uns auf die Konsequenzen: Wie viele von uns bin ich mit der Überzeugung aufgewachsen, dass sich durch sorgfältige Analyse eine Lösung finden lässt. Mit meiner Ausbildung in Mathematik und Ingenieurwesen schaue ich auf ein Problem („sense“), analysiere es und verstehe seine Eigenschaften („analyse“), um dann eine Lösung zu entwickeln („respond“). Mit der richtigen Ausbildung und einigen Jahren Erfahrung werde ich zum Experten — etwa im Projektmanagement — und wende diese Praktiken routiniert an. Wo ordnet das Cynefin-Framework diesen Ansatz ein? Richtig: in der Complicated-Domäne. Soweit, so gut. Das Problem entsteht, wenn wir unsere Good Practices in die Complex- oder Chaotic-Domäne übertragen. Dort lässt sich die Ursache-Wirkung-Beziehung nicht vorhersagen. Wir brauchen einen grundlegend anderen Ansatz. In der Complex-Domäne müssen wir zuerst etwas ausprobieren („probe“), dann beobachten, wie sich die Dinge entwickeln („sense“), und auf Basis des Feedbacks weitermachen oder unseren Ansatz ändern („respond“). Das ist im Kern das, worum es bei agilen Methoden geht. Sie betonen schnelles Feedback — und das Handeln auf dieser Grundlage. Auf die erste Metapher zurückkommend: Wir geraten in Schwierigkeiten, wenn wir das falsche Werkzeug (den Hammer) in einer bestimmten Umgebung einsetzen. Am häufigsten sehe ich Good Practices aus der Complicated-Domäne, die in der Complex-Domäne angewendet werden — etwa Projektmanagement- und Programmmanagement-Methoden in komplexer Produktentwicklung oder bei Transformationen. Manchmal aber auch umgekehrt: wenn agile Methoden in Situationen eingesetzt werden, in denen wir bereits funktionierende Good Practices haben.

    Außerdem: Wer das Cynefin-Framework kennt, kann viele Diskussionen rund um die digitale Transformation deutlich entspannter führen. Denn es geht nicht darum, welche Arbeitsweise besser ist. Ist Agile besser als Waterfall? Oder umgekehrt? Das ist grundlegend die falsche Frage. Die richtige Frage ist, ob die Werkzeuge und Ansätze zur jeweiligen Domäne passen.

    Ich wünschte, ich hätte Cynefin viel früher gekannt. Es hätte mir und meinen Teams eine Menge vergeudeter Energie erspart — als demjenigen, der das falsche Werkzeug benutzt hat. Oder es hätte mir die Zuversicht und die Argumente gegeben, laut zu sagen, wenn etwas grundlegend schiefläuft — als Opfer. Ich wünschte, wir alle würden das Cynefin-Framework kennen. Warum also nicht in der Schule darüber reden? Bis dahin: Hilf mit, uns eine Menge vergeudeter Energie zu ersparen. Schau es dir selbst an — und erzähl anderen davon.
  • Anti-Pattern: Dieser Schuss muss sitzen

    In diesem Video geht es um ein Muster, das ich in letzter Zeit in der IT-Branche immer wieder beobachte. Es ist ein Anti-Pattern — eine Denkfalle, die ich „dieser Schuss muss sitzen“ nennen möchte. Oder anders gesagt: Dieses Projekt muss ein Erfolg werden.

    Trotz allem, was wir über große und komplexe IT-Programme wissen, werden sie immer wieder aufgesetzt. Wir wissen, dass sie ein hohes Scheitern-Risiko tragen, dass sie sich verzögern, ihre Budgets sprengen und Kunden am Ende oft unzufrieden sind. Ich war selbst Mitglied in einigen dieser Death Marches — ich weiß, wovon ich spreche.

    Aber warum greifen Unternehmen immer noch zu diesen großen und komplexen IT-Projekten? Trotz des Wissens um ihre Umsetzungsrisiken. Trotz des Wissens, dass die Erfolgschancen steigen, wenn man zum Beispiel die Batch-Größe reduziert — also große Initiativen in mehrere dünne Scheiben schneidet.

    Seien wir ehrlich: Es gibt Programme, die von Natur aus groß und komplex sind. Denk an den Bau einer großen Brücke oder einer Bahnstrecke zwischen zwei Städten. Ein agiler Ansatz — schnell Wert liefern, Initiativen aufteilen, mit MVPs experimentieren — funktioniert dort nicht wirklich. Zumindest nach meiner Kenntnis. Wenn du Gegenbeispiele kennst, freue ich mich über Kommentare — das interessiert mich wirklich. Manche Herausforderungen lassen sich eben nicht in Größe, Komplexität, Risiko und Zeitrahmen verkleinern. Und als kleiner Vorgeschmack: Das Cynefin-Framework hilft zu verstehen, warum manche Herausforderungen grundlegend anders sind als andere.

    Zurück zu den heutigen IT-Programmen. Vor einigen Tagen moderierte ich einen Runden Tisch zum Thema Portfolio-Management. Eine Teilnehmerin sagte, die Ära der großen und komplexen Programme sei vorbei. Ich dachte: Sie hat recht — aber das entspricht nicht dem, was ich draußen sehe. Immer wieder stoße ich auf große und komplexe IT-Programme, die mit unrealistischen Zeitplänen, unklaren Ergebnissen und hohen Risiken aufgesetzt werden. Ich höre IT-Manager sagen: „Dieses Projekt muss ein Winner werden.“ „Diesmal müssen wir es wirklich richtig machen.“ „Wir setzen alles auf eine Karte.“ Oder sogar: „Die Zukunft unseres Unternehmens hängt von dieser strategischen Chance ab.“

    Dann denke ich: Die sollten es besser wissen. Sie sollten die Risiken großer und komplexer IT-Programme kennen. Sie sollten die Möglichkeit sehen, dünne Scheiben zu schneiden, mit MVPs zu starten. Oder Methoden wie R.A.T. (Riskiest Assumptions Tested) zu nutzen. Warum kommen sie nicht dahinter? Es liegt alles auf dem Tisch — die Evidenz auf der einen Seite, die Prinzipien, Techniken und Tools auf der anderen. Und ja, ich höre Klagen von Managern, die selbst in diesen Death Marches stecken. Was passiert da also?

    Ich bin zu der Überzeugung gelangt, dass es nicht der Wunsch einzelner Personen nach großen und komplexen IT-Programmen ist, der dieses Anti-Pattern erzeugt. Das Problem ist systemischer Natur. Die Ursache liegt in dem, was aus reifen Unternehmen über die Zeit geworden ist. Und es sind genau diese reifen Unternehmen, bei denen ich dieses Anti-Pattern beobachte. Es liegt in der Management-Hierarchie, die reife Unternehmen über Jahre des Wachstums aufgebaut haben. Diese Hierarchie kennst du. Sie ist die vorherrschende Organisationsstruktur in entwickelten, reifen Unternehmen.

    Kurz gesagt: Wenn Unternehmen wachsen und reifen, nutzen sie Skaleneffekte, um einst differenzierte Leistungen zu günstigeren Preisen anzubieten — weil die Konkurrenz aufholt. Das müssen sie, um im Wettbewerb zu überleben. Und dabei entstehen Silos. Diese Silos können ein Unternehmen effizienter machen, gleichzeitig aber auch weniger flexibel und anpassungsfähig.

    Also: Management-Hierarchie und Silos.

    Schauen wir uns an, wie Entscheidungen in dieser Hierarchie getroffen werden.

    Entscheidungen wandern in der Hierarchie nach oben. Sie blubbern hoch. Manager delegieren Entscheidungen in der Regel nicht nach unten — an die Teams oder die betroffenen Personen. Ein Grund dafür: Teams haben meistens keine End-to-end-Verantwortung für die Produkte oder Services, die sie entwickeln. Sie sind in der Regel nicht autonom. Sie sind auf Input und Abstimmung mit anderen Teams angewiesen. Das ist eine direkte Konsequenz der Silo-Struktur. Vergessen wir nicht, warum diese Silos überhaupt existieren. Innerhalb von ihnen können sich Menschen spezialisieren, tieferes Wissen und Fähigkeiten aufbauen — gemeinsam mit Kolleginnen und Kollegen, die an ähnlichen Problemen arbeiten. Sie sammeln mehr Aufgaben desselben Typs und können so automatisieren und Pooling nutzen, um effizienter zu werden.

    Nehmen wir an, ein Team möchte eine bestimmte Fähigkeit implementieren oder eine Änderung vornehmen. Da das Team nicht autonom ist, braucht es Unterstützung von einem oder mehreren anderen Teams oder Kolleginnen und Kollegen aus anderen Abteilungen. Aus einer Teamarbeit wird eine koordinierte Initiative über mehrere Teams hinweg. Der Scope wächst. Und durch die notwendige Abstimmung und die Übergaben steigt auch die Dauer. Die Entscheidung liegt nicht mehr bei einem einzelnen Team — sie wandert in der Hierarchie nach oben. Und sie wächst in Scope und Wirkung, je mehr Teams betroffen sind. Veränderungen und die damit verbundenen Entscheidungen werden immer komplexer — und damit auch riskanter. Das Management erkennt das. Es schickt Teams zurück, um die geplante Änderung weiter zu analysieren und das Risiko zu reduzieren. Diese gut gemeinte Aufgabe verlangsamt die Umsetzung zusätzlich. Ich habe selbst mehrere dieser Analysen und Machbarkeitsstudien erlebt, deren Ergebnisse ordentlich aufbereitet wurden — und die dann NIEMAND, wirklich niemand, sich angeschaut hat. Weil inzwischen dringendere Fragen aufgetaucht waren. Das ist eine enorme Quelle von Verschwendung. Und natürlich verlieren die Menschen, die diese mühsame Analysearbeit leisten, mit der Zeit ihre Motivation.

    Da Veränderungen in reifen Unternehmen länger dauern, verpasst man auch die Chance, die Wirkung von Initiativen schnell zu sehen und daraus zu lernen. Statt auf konkreten Ergebnissen aufzubauen, muss man sich auf Business Cases und Management-Narrative verlassen.

    Vor diesem Hintergrund mache ich keine einzelne Person dafür verantwortlich, ein großes und komplexes Programm zu starten — oder zu sagen: „Dieser Schuss muss sitzen.“ Es ist die Organisationsstruktur reifer Unternehmen, die große und komplexe IT-Projekte hervorbringt. Es ist das System. Und solange wir nicht beginnen, die Struktur der Organisation zu verändern, werden digitale Transformationen weiterhin scheitern. Und wir werden weiterhin große und komplexe Projekte sehen — von denen viele scheitern werden.

    Was können wir also tun? Ehrlich gesagt: Ich bin nicht sicher. Digitale Transformationen sind schwierig. Aber wenn man das agile Prinzip ernst nimmt, klein anzufangen, ist der erste Schritt: Bewusstsein schaffen. Die Auswirkungen der Management-Hierarchie und der Silos verstehen. Sehen, wie es anders gehen kann. Wirklich agile Unternehmen beobachten. Erleben, wie autonome Teams arbeiten. Aber Vorsicht vor Faux-Agile und Cargo-Cult-Agile. Fahr also ins Valley — oder fang hier in Berlin an. Und das gilt nicht nur für die Entwicklungsteams. Gerade Manager sollten über die Konsequenzen von Silos und Management-Hierarchie nachdenken. Lies über die Evidenz. Lies über Conway’s Law. Wenn du VP oder Director bist, überleg es dir zweimal, bevor du das nächste Mal eine Machbarkeitsstudie anforderst. Warum nicht stattdessen nach einem MVP fragen und vom Nutzer-Feedback lernen? Wenn du Program Manager bist, überleg es dir zweimal — und sei ehrlich mit dir selbst: Willst du wirklich 18 Monate warten, um erste Ergebnisse zu sehen? Die Wahrheit ist: Du bekommst diese Ergebnisse vielleicht nicht mal in 18 Monaten — es könnte länger dauern, und du bekommst vielleicht nicht das, was du dir erhofft hattest. Hör genau hin, wenn dir das nächste Mal jemand sagt, dieses Projekt muss ein Winner werden. Frag danach, wie eine dünne Scheibe aussehen könnte. Das ist nicht einfach — zugegeben. Aber diese großen und komplexen Programme und Death Marches auch nicht.

  • Vorlage zur Berechnung von Business Value Points

    In meinem Video über Lean & Agile Portfolio Management beschreibe ich den Einsatz von Business Value Points, um Investitionsentscheidungen objektiver zu machen. Ich stelle ein Arbeitsblatt vor, mit dem ich Business Value Points (BVP) berechne. Um die Berechnung zu erleichtern, stelle ich dir eine Vorlage zur Verfügung, mit der du dein eigenes Berechnungsschema erstellen kannst.

    Project Value Sheet Template

  • Distributed Delivery: Game Changer für Software-Exzellenz im großen Maßstab

    Offshoring ist für viele eine verlängerte Werkbank für IT-Projekte. Für uns war es das nie. Wir bei Thoughtworks leben das Konzept der agilen Softwareentwicklung in global verteilten Teams oder auch Distributed Delivery. 

    In diesem Webinar diskutiere ich mit David Toborek (Metro Digital), Daniel Loeffelholz (Thoughtworks), Sven Dittmer (Mercedes-Benz) und Lucy Chambers (Thoughtworks) über Distributed Software Delivery.

    Hier geht es zu Aufzeichnung des Webinars:

  • Die 20 häufigsten Fehler in der agilen Offshore-Softwarelieferung

    Seit vielen Jahren bin ich in der verteilten Softwareentwicklung tätig. Anfangs im Wasserfall-Modus, seit 2017 auch in agiler verteilter Delivery. Ich habe viele Engagements scheitern sehen — und war auch Teil von erfolgreichen Delivery-Setups. Hier ist meine persönliche Top-20-Liste der Fehler in diesem Bereich.

    Nr. 20: Offshore-Teams zu spät einbinden
    Nr. 19: Reisekosten nicht ausreichend einplanen
    Nr. 18: Nicht in die Kommunikationsinfrastruktur investieren
    Nr. 17: Zeitzonenunterschiede und kulturelle Gepflogenheiten bei der Planung von Ceremonies vernachlässigen
    Nr. 16: In der Kommunikation kein Level Playing Field schaffen
    Nr. 15: Alle Offshore-Standorte gleich behandeln
    Nr. 14: Fehlende Abstimmung über das Delivery-Modell
    Nr. 13: Versuchen, denselben Arbeitsmodus für alle Teams durchzusetzen
    Nr. 12: Das Einheitsmodell in der Delivery verwenden
    Nr. 11: Verteiltes Arbeiten für das falsche Engagement wählen
    Nr. 10: Den Offshore-Teams die falsche Arbeit zuweisen
    Nr. 9: Das Rollenmodell nicht erweitern
    Nr. 8: Sprachliche Unterschiede ignorieren
    Nr. 8: Politische und kulturelle Unterschiede zwischen den Standorten nicht verstehen
    Nr. 6: Beziehungsaufbau vernachlässigen
    Nr. 5: Keinen direkten Zugang zu Nutzern und Kunden sicherstellen
    Nr. 4: Die Business-Perspektive vergessen
    Nr. 3: Das Gesamtbild für die Offshore-Teams nicht vermitteln
    Nr. 2: Offshore-Teams nicht auf Augenhöhe behandeln
    Nr. 1: Es aus den falschen Gründen tun — d. h. nur auf den Preis schauen

  • Future Skill „Vielseitigkeit“

    Dies ist die Aufnahme eines Webinars zum Thema „Vielseitigkeit“. Sylvia Kern, Tanja Merz und Linda Barron stellen sich als Scanner-Persönlichkeiten vor. Ich habe die Diskussion moderiert und die Fragen aus der Zuhörerschaft aufgenommen.

    Die Digitale und Agile Transformation benötigt ein agiles Mindset, agile Methoden, Know-how und die Kompetenz, komplexe Anforderungen zu lösen. Komplexe Antworten finden wir jedoch nur in der Vielfalt und der Vielseitigkeit von Menschen und ihren Fähigkeiten.

    Bisher wurde das Augenmerk zu sehr auf die Expert:in gelegt, zu wenig wurde erkannt, wie wichtig ein vielfältiges Know-how ist. In Zukunft werden die Scanner, Multipassionates in der Business-Welt nicht mehr wegzudenken sein. Disruption bedeutet, Geschäftsmodelle, Technologien, Strukturen uvm. aufzubrechen – Startups sind beispielsweise Meister darin.

    Routine Aufgaben werden künftig immer mehr von der Digitalisierung abgelöst, was bleibt, sind die komplexen Herausforderungen, die durch cross-funktionale Teams gelöst werden. Wer neue Wege beschreiten möchte, muss nach unkonventionellen Möglichkeiten suchen. In Zeiten von Digitalisierung & New Work sind Menschen gefragt, die anders denken können, Vielfalt wollen und diese auch selbst leben. Es sind diejenigen gefragt, die anders denken wagen, die Mut, Intelligenz und Führungsqualitäten mitbringen und sich sehr gerne neuen Herausforderungen stellen wollen.

  • Micro Frontends

    Micro Frontends sind ein Architekturstil, der die Idee von Microservices auf den Frontend-Teil von (Web-)Anwendungen überträgt. Ich spreche mit Ward Coessens, MengMeng Yan und Eka Rudianto über ihre Erfahrungen mit dem Einsatz von Micro Frontends.

    Wir behandeln folgende Themen:

    1. Warum braucht man Micro Frontends?
    2. Der Browser als Entwicklungsplattform
    3. Wie haben wir 2017 mit Micro Frontends begonnen?
    4. Welche Erfahrungen hast du als Entwickler mit Micro Frontends gemacht?
    5. Sind Micro Frontends für den Nutzer sichtbar?
    6. Wie kommunizieren verschiedene Teile des Frontends miteinander?
    7. Welche Beziehung besteht zwischen Micro Frontends und Microservices?
    8. Wie hängt das mit autonomen, cross-funktionalen Teams zusammen?
    9. Wie funktioniert das in der Praxis?
    10. Sollte man ein eigenes Framework bauen?
    11. Sollte man jetzt Micro Frontends für alle Webanwendungen einsetzen?
    12. Wie lässt sich ein einheitliches Design-Erlebnis sicherstellen?
    13. Wie sieht eine interaktive Komponentenbibliothek aus?
    14. Wo findet man weitere Informationen?
  • Learning Breakthroughs #2: Steering Committees

    In agilen Umgebungen brauchen wir keine Steering Committees. Steering Committees sind eine aussterbende Spezies. Sie sind Teil einer veralteten Governance-Struktur, die für das heutige produktorientierte Umfeld nicht mehr geeignet ist.

    In diesem Video erzähle ich die Geschichte meiner Beziehung zu Steering Committees — und wie ich lernen musste, sie als Governance-Instrument zu verlernen.

  • Modernes funktionales Programmieren mit Clojure

    Clojure. Das ist eine moderne funktionale Programmiersprache. Nicht nur Menschen, die gerade das Buch The Unicorn Project gelesen haben — in dem funktionales Programmieren eine Rolle spielt —, fragen sich, was es mit dieser Sprache auf sich hat. Warum wird funktionales Programmieren in der Geschäftswelt immer interessanter? Ich wollte wissen, was hinter diesem Hype steckt, und habe mich deshalb mit meinen Kollegen Ward und Naveen zusammengetan, die mir geholfen haben, Clojure besser zu verstehen.

    In dieser Folge von Thoughtworks Tech Talk nehmen wir Clojure unter die Lupe. Wir besprechen das funktionale Paradigma, schauen uns Immutability an und erklären, warum Clojure dadurch besonders gut für parallele Verarbeitung geeignet ist.

    Wir schauen uns außerdem echten Clojure-Code an — angefangen mit einem Hello World bis hin zu Map-Reduce in Clojure. Wie schwer ist es, Clojure zu lernen, und was hilft beim Einstieg?

  • Learning Breakthroughs #1: Risikomanagement

    Dieses Learning-Breakthroughs-Video handelt davon, was ich über das wirklich Wesentliche im Projektrisikomanagement gelernt habe. Nach einer kurzen Einführung in das Risikomanagement nach dem Project Management Institute (PMI) erzähle ich, wie ich Risiken in einem großen HR-Payroll-Outsourcing-Projekt gemanagt habe. Das hat mich zu einer entscheidenden Erkenntnis geführt: Es kommt darauf an, aus dem Risk Log konkrete Maßnahmen abzuleiten — und sich auch wirklich dazu zu bekennen. Darüber hinaus ist es wichtig, bewusste Entscheidungen zu treffen, diese zu kommunizieren und dabei die eigenen Teams sowie Stakeholder einzubeziehen.